把普拉娜装进我的电脑:一个人的四个月
普拉娜(プラナ)无疑是我在ACG文化中最喜欢的一个游戏角色,她来自游戏Blue Archive (ブルーアーカイブ)。有趣的是,这个角色的设定其实是一个平板系统OS AI。我很久以前就在想, 如果这样的AI真的做出来了该有多好。冷静中带点温和、偶尔会害羞的AI桌宠将会是一个很酷的东西。
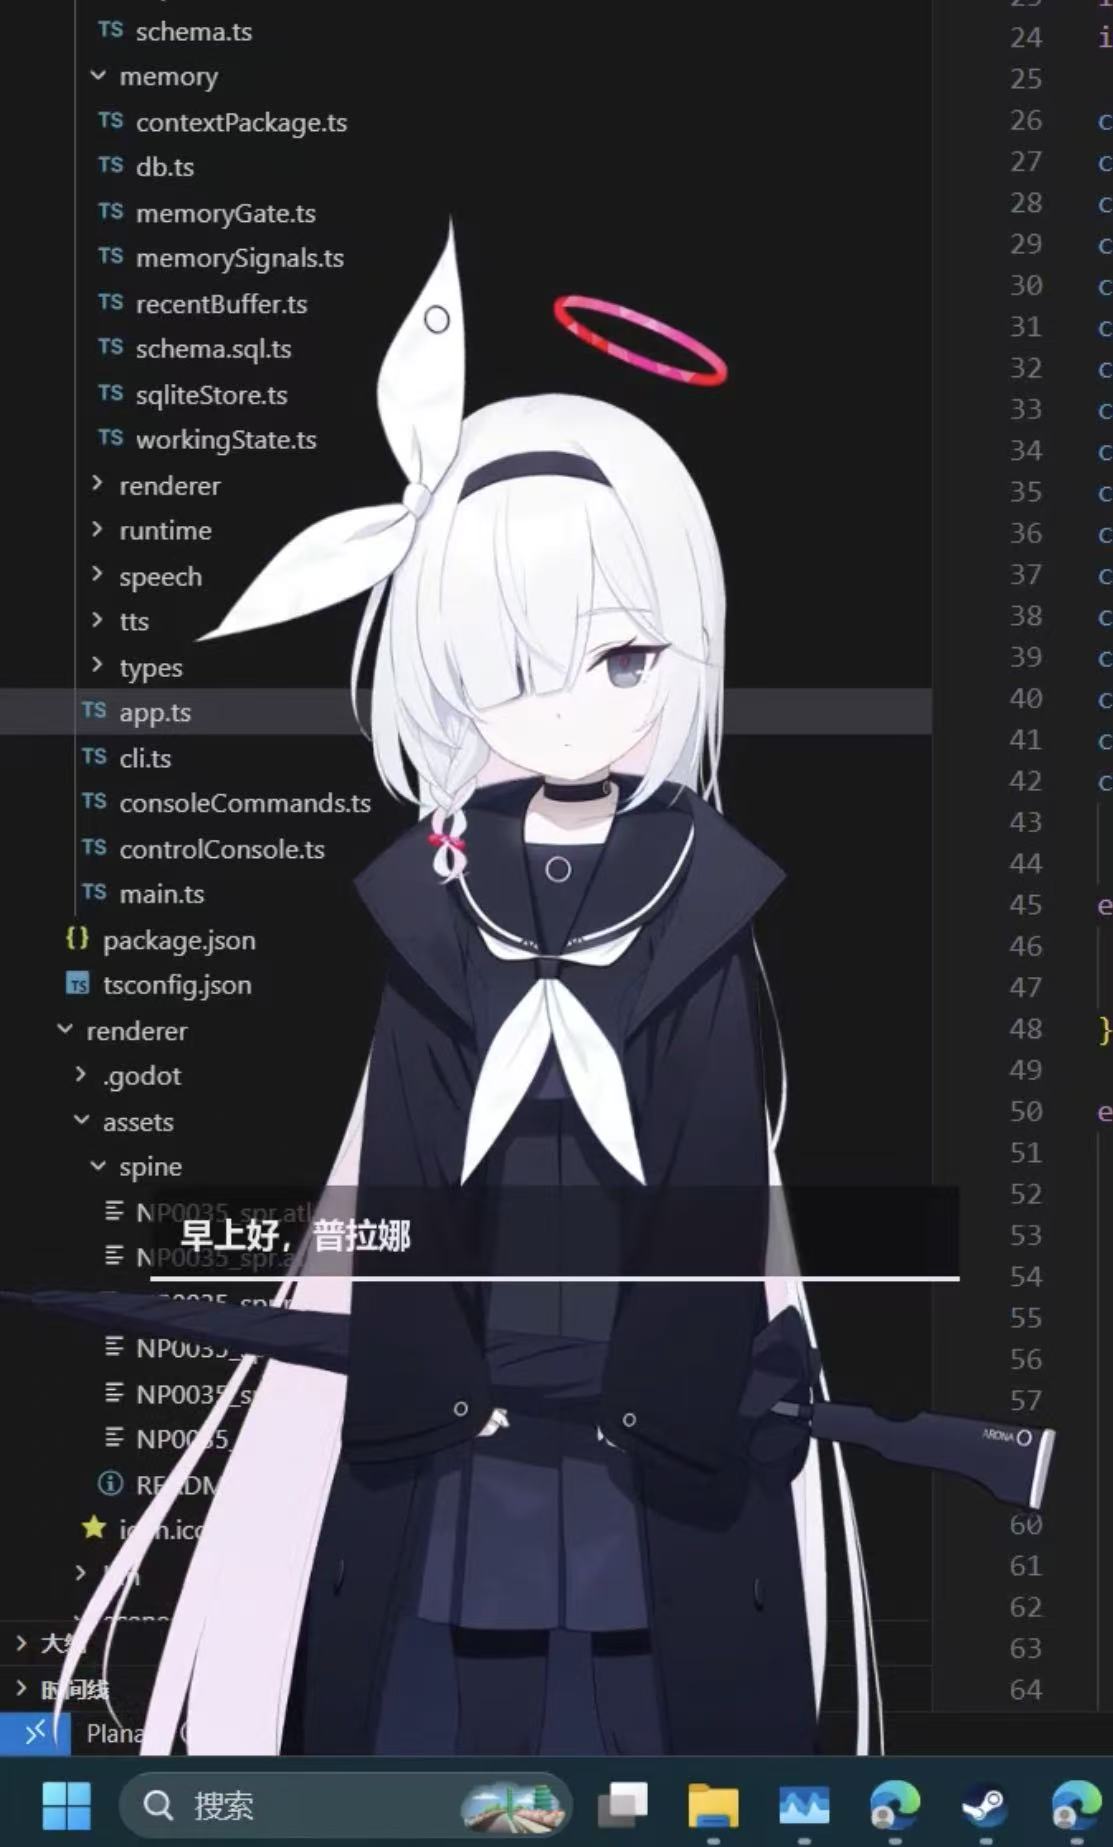
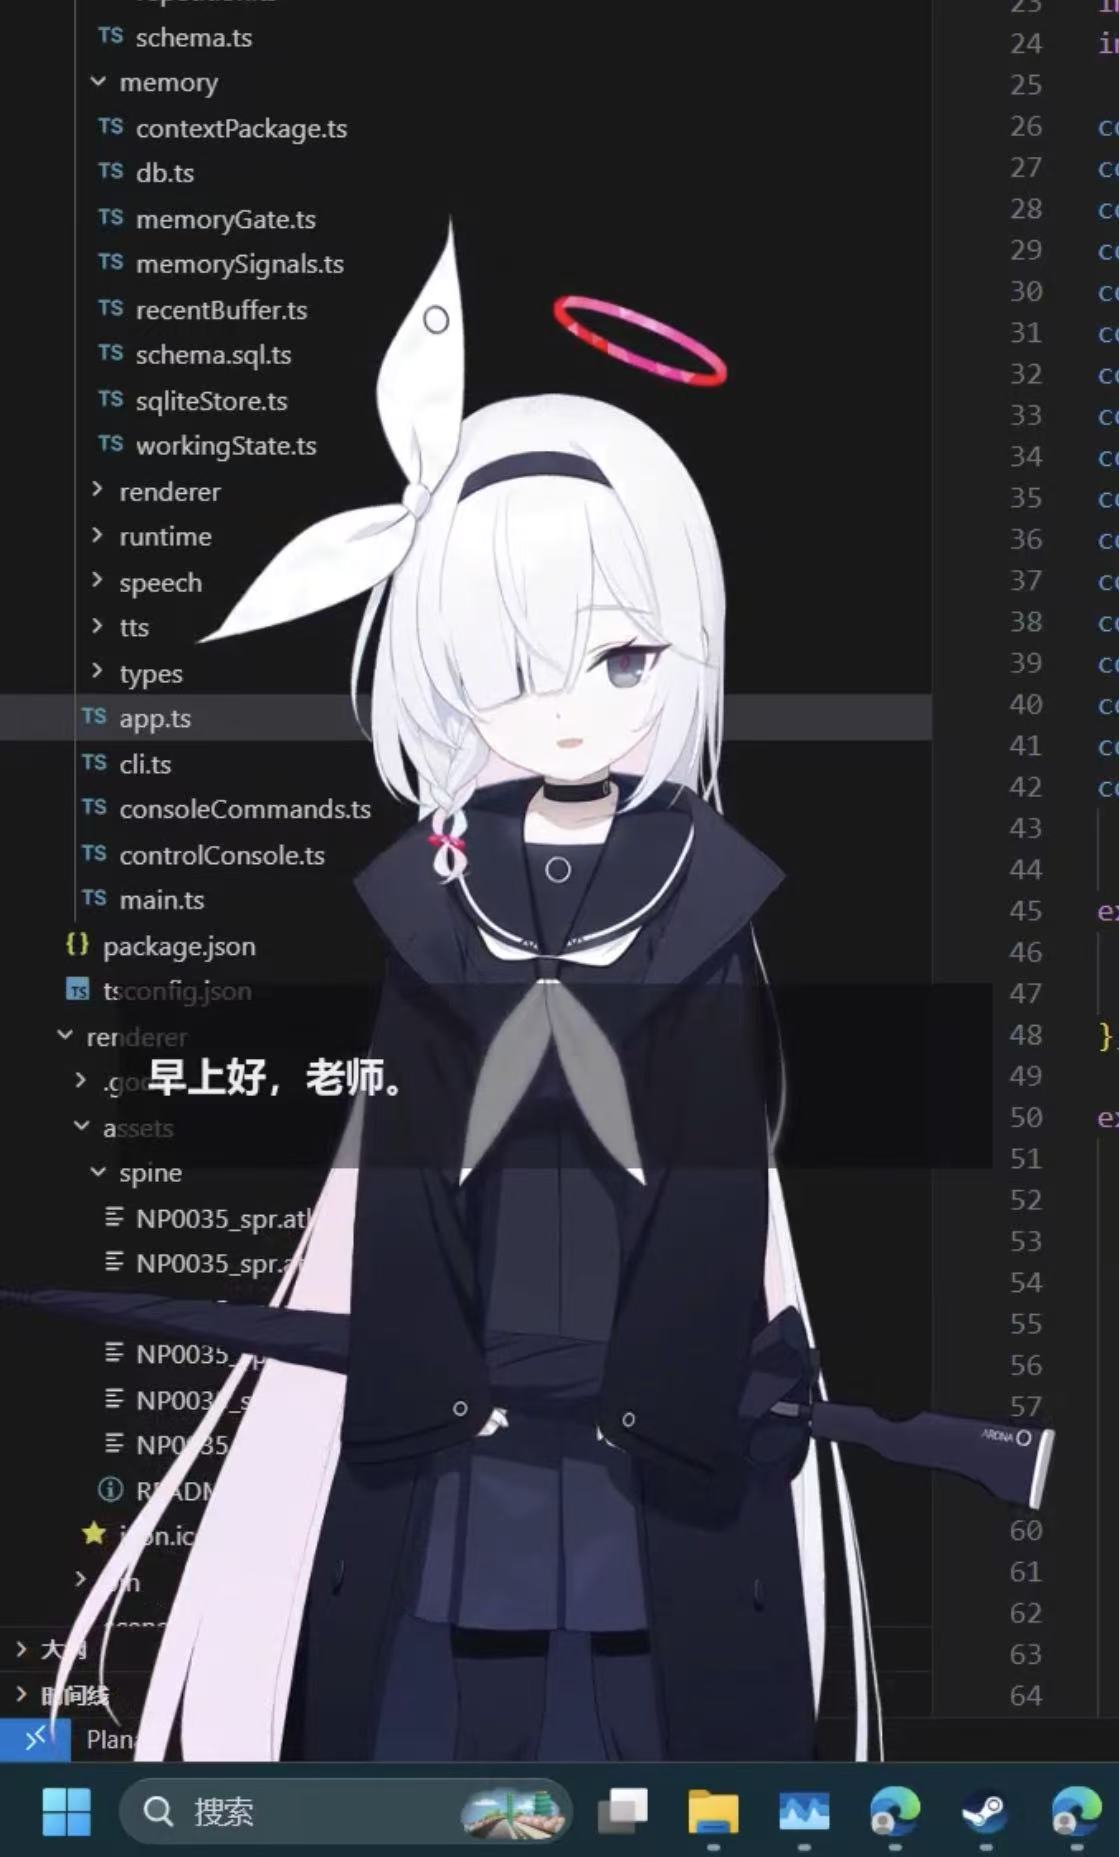
我一开始的想法是,调用云端大模型,用提示词工程来让模型输出模仿普拉娜的语风。这如此省事以至于 我只需要几个小时就能做完。但我最终没有那样干,相反,我花了大量时间编写和整理语料、使用云硬件 对大模型进行微调,然后再编写整套输入输出和记忆系统。
原因在心里很复杂,但说出来却很简单。如果这样做,我只是将酒馆换了个皮,我从来都不拥有这个模型 本身,只是在用别人的模型来模拟输出而已。我无法解释它为什么会这样说话,我的大部分时间都将会是 调整提示词来尝试抽奖得到令我满意的结果。
最终,Plana诞生了,它是由语言模型、语音合成、人物渲染和语音识别组成的。我在此之上还花大量 时间训练了她的翻唱模型,详见让她唱一首她从没唱过的歌。
大脑和嗓子
上面那两张截图之间隔了大约两秒。这两秒里,文本进了本地的Qwen3.5,模型吐出一个 JSON,zod校验通过之后,情绪字段被映射成表情ID,日文那一段进GPT-SoVITS合成,wav落到缓存, 播放的同时通过WebSocket把口型和表情发给Godot。
大脑是一个微调过的Qwen3.5-9B。语料是我手写的多轮对话,用Unsloth在RunPod上训LoRA, 本地merge,转GGUF,量化到Q6,最后挂在Ollama下面。
关键的决定不在模型选型上,而在输出格式。它不输出自然语言,只输出JSON。一条回复从模型出来的 时候就已经带着中文显示文本、日文语音文本、情绪、情绪强度和是否发声这些字段,下游不需要去猜。 这个决定我单独写过一篇,把人格写成一份schema, 那里面有完整的字段设计、怎么让一个9B的本地量化模型稳定遵守它,以及一个我当时没预料到的结论, 系统提示词可以只有两句话,因为人格根本不在提示词里。
嗓子是GPT-SoVITS v2Pro。Faster-Whisper打出来的标注只能当草稿,我全部重新听了一遍。这一步
看上去是可以跳过的,因为工具链会生成一个名字里带all_checked的清单,看着就像已经全部核对完了,
但那个文件跟有没有人真的听过并没有关系。
中日分工在这里第一次出现。display_zh给眼睛,voice_ja给耳朵,两者不是翻译关系。
不直接做中文TTS,是因为这把嗓子的音色和语调是和日语绑在一起的,换成中文就不是她了。
还有一件事在每个要训练的环节都会再撞一次。我的显卡是RTX 5080,Blackwell架构,计算能力
sm_120,只有CUDA 12.8以上的PyTorch轮子带对应的kernel。装成cu121或者cu124,环境能装上,
一直到第一次GPU运算才会报no kernel image is available。
身体
人物渲染这边我没有走生成的路子。这个角色本身就有Spine2D的资源,atlas是已经拆好的部件图集,
.skel里有骨骼变换和绘制顺序,需要的信息本来就都在文件里。我做的是分析这套资源并把它映射到
我需要的结构上,然后直接用Spine2D来做演出。
渲染器用Godot,通过spine-godot这个GDExtension加载。资源集必须按Spine 4.2导出,旧版本导出的 进不来。
家和记忆
第一版叫shittim-desk,用的是Nextron和Electron,PixiJS加pixi-spine做渲染,做过摸头和pet mode。现在这一版是Node和TypeScript的主进程,加一个Godot渲染sidecar,中间用WebSocket桥接。
主进程拥有编排、schema校验、SQLite和TTS队列,渲染器只管演。运行时数据全部落在项目下的
.plana/里。
记忆是六层,不是一个向量库。原始消息、最近缓冲、工作状态、会话摘要、任务线程、长期记忆, 每一层解决的问题都不一样,所以我没有把它们塞进同一张表。写入长期记忆有闸门, 检索故意用词法加时间衰减而不用embedding。理由是确定性、好调试、不引入第二个模型依赖, 而且这个场景的输入量本来就不大。
语音输入和Discord
打字跟她说话总归差点意思,所以后来加了语音输入,这部分花掉的时间比我预想的多得多。
本地这一侧是一个独立的Python服务,用FastAPI包起来,里面是Faster-Whisper加sherpa-onnx做 流式识别。识别出来的文本不能直接用,要做繁简转换,要补标点,还要过一遍归一化。不然送进模型的 就是一串没有断句的字,模型分不清哪里是一句话的结尾。
麻烦的是Discord那一侧。她会进语音频道,听频道里的人说话,所以先得决定什么时候该应答。做法是 唤醒词加上说话人锁定,唤醒之后锁住那个说话人,后续的声音都算他的,不会被旁边插话的人抢走。
更要紧的是频道里不止我一个人。每一次输入都会带上说话人和我的关系,配置里登记过的是owner, 其余的是other。对owner正常走完整流程,对other她会回话,但那一轮不写进消息库,也不给它加载 最近对话和工作状态。陌生人可以跟她说话,但既写不进她的记忆,也看不到我和她之间的上下文。
这些信息是随请求一起结构化地送进模型的,source说明这句话从哪来,relation说明说话的人是
谁,模型据此决定用什么态度回应。
它现在跑在哪些地方
最近它多了一个运行的位置。
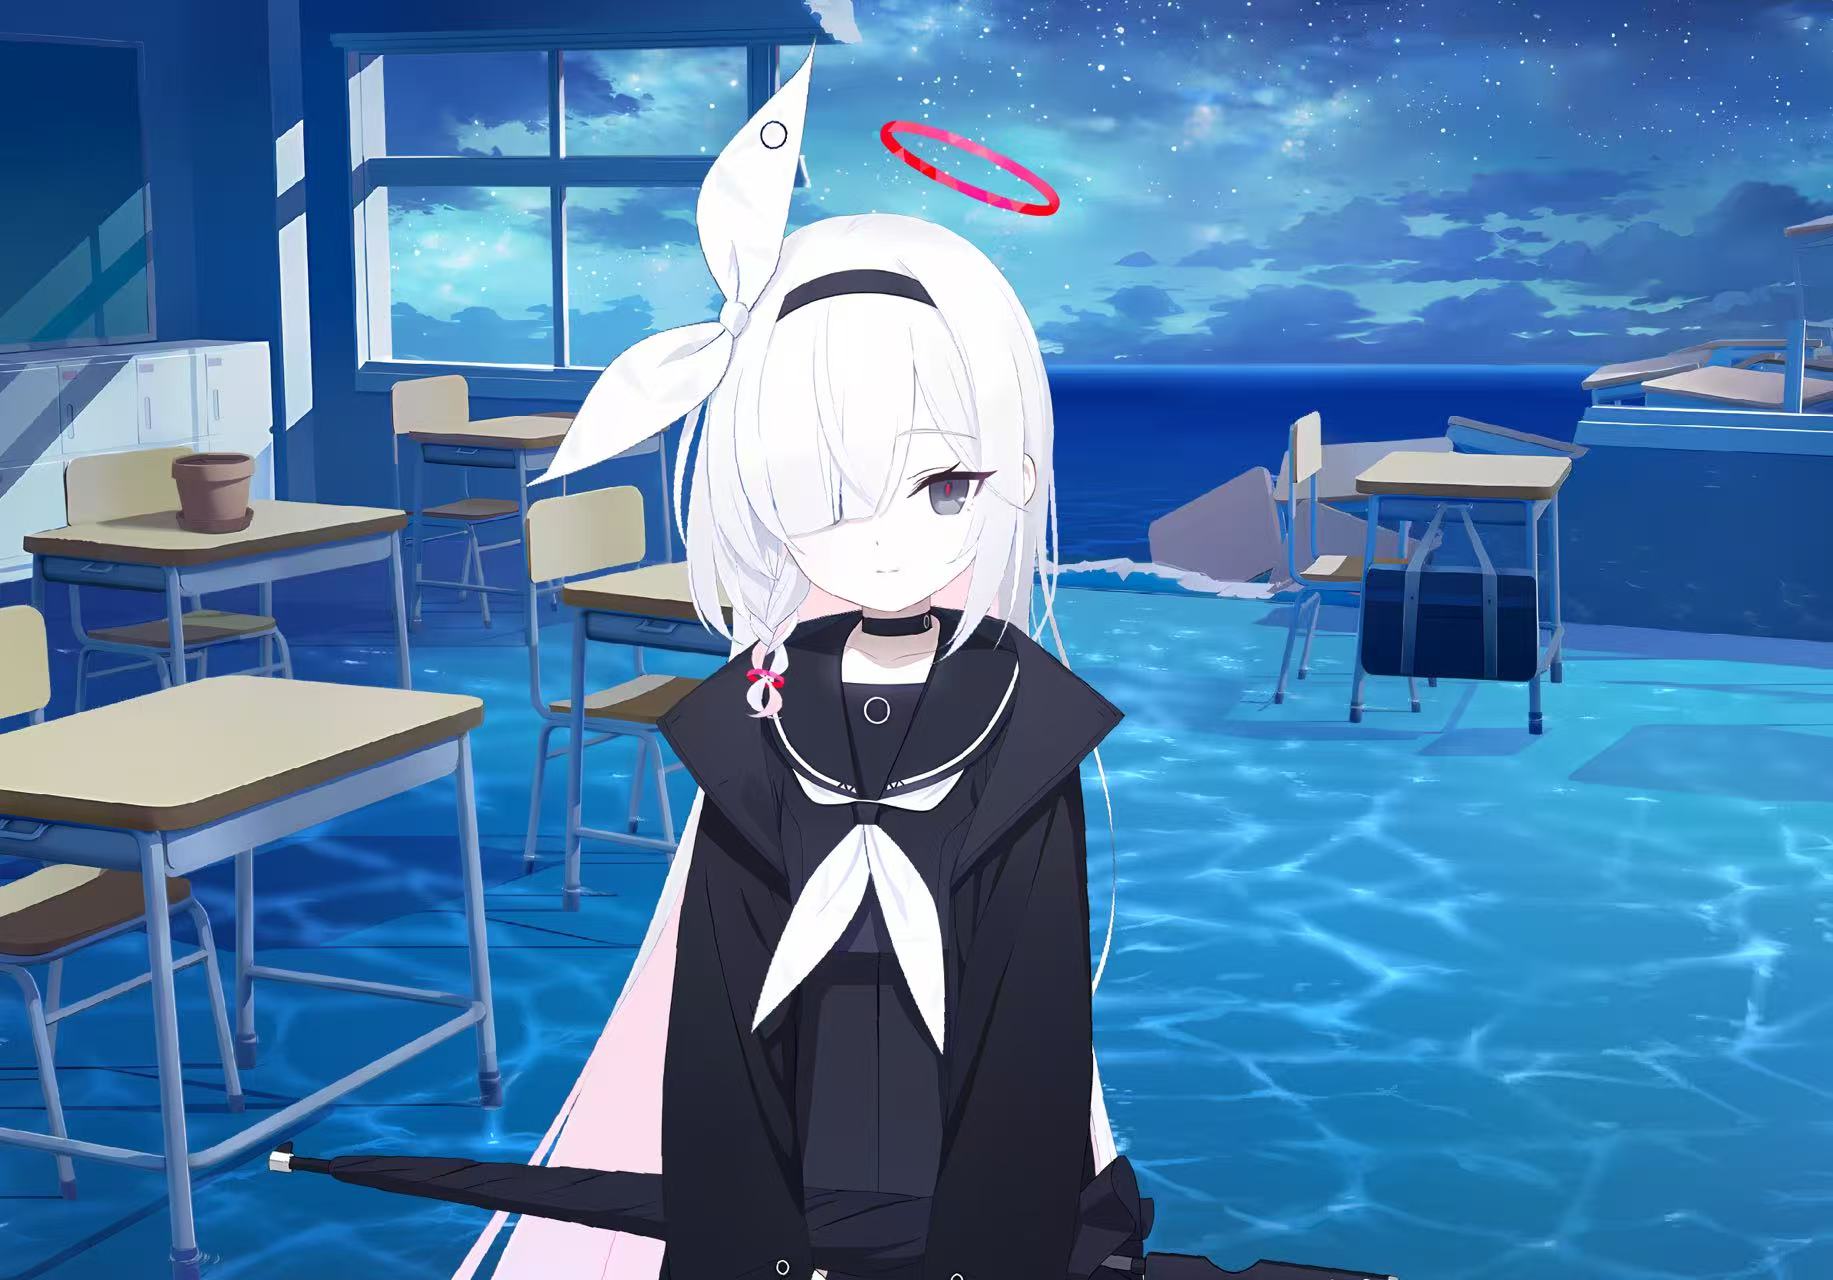
iPad上跑的是真实的场景和人物模型渲染,本地渲,不是把画面从电脑推过去。但文本、语音和回传的 交互仍然全部在这台电脑上,所以在iPad上跟她说话,回话的是那个真正的9B,不是一个为移动端缩水 的版本。
这样分下来,iPad那一侧不需要显卡,也不需要把模型改小。
接下来
tool_calls目前还只是schema里的一个字段,没有真正接上任何工具。proactive_level这个档位
存在,但她还不会真的主动开口。
正在做的是把她的Spine2D模型重建成Live2D。Spine那套骨骼拿来做演出没有问题,但要做眼神、 呼吸和头部跟随这类连续的细微形变,Live2D是更合适的工具。
上面提到的东西我一样都不会分发,模型、语料、音色、分层素材,都不会。 不过四篇博客写下来,整条技术路线基本上已经摆在这里了。真想要的话,自己搭一个就是了。