2x 超分:模型对比与踩过的坑
一批带 alpha 通道的二次元角色素材需要放大到两倍。原本预计是挑一个模型跑一遍的工作量, 实际花了两天,其中大部分时间用在评测方法本身,中途推翻过一次结论。 本文记录试过的模型、遇到的问题,以及最终的选型依据。
环境
模型统一用 spandrel 加载,没有安装 basicsr。
后者与新版 torchvision 和 Python 3.12 的兼容性有问题,而 spandrel 支持 42 种超分架构,
可以直接读 .pth 权重推理。准备的 16 个权重全部加载成功,没有候选因为拿不到权重被跳过。
spandrel 0.4.2 / torch 2.8.0+cu128 / RTX 5080
fp32,分块推理 + 上下文边(丢弃边缘,只保留块的核心)
素材由几百个小块组成,最小的只有 8×5 和 14×3,全部带直通(非预乘)alpha。 尺寸小和带 alpha 这两个特征,是后面大部分问题的来源。
试过的模型
| 候选 | 架构 | 参数 | 倍率 | 来源 |
|---|---|---|---|---|
RealESRGAN_x4plus_anime_6B | ESRGAN 64nf/6nb | 4.47M | x4 | Real-ESRGAN release v0.2.2.4 |
realesr-animevideov3 | SRVGG | 轻量 | x4 | 同上(下载后未采用) |
DAT_2_x2 / DAT_2_x4 | DAT medium | 11.1M | x2 / x4 | HF silveroxides/DAT_upscale_models |
IllustJaNai_DAT2_x4 | DAT + 动漫插画微调 | 11.2M | x4 | HF tomjackson2023/upscale_models |
HAT_L_x4 | HAT large | 40.9M | x4 | HF anchuang/HAT-L_SRx4_ImageNet-pretrain |
RealHAT_GAN_sharper_x4 | HAT medium | 20.8M | x4 | HF anchuang/Real_HAT_GAN_SRx4_sharper |
APISR2x_RRDB | ESRGAN unshuffle | 4.47M | x2 | GitHub Kiteretsu77/APISR |
APISR4x_RRDB / _GRL / _DAT | ESRGAN / GRL / DAT | 4.47 / 1.03 / 10.9M | x4 | 同上 |
cugan2x_{conservative,no-denoise,denoise1x} | RealCUGAN | 1.28M | x2 | bilibili/ailab Real-CUGAN |
cugan4x_conservative | RealCUGAN | 1.41M | x4 | 同上 |
AnimeSharp_x4 | ESRGAN 23nb | 16.7M | x4 | HF Kim2091/AnimeSharp |
Remacri_x4 | ESRGAN 23nb | 16.7M | x4 | HF FacehugmanIII/4x_foolhardy_Remacri |
LANCZOS | — | — | x2 | 对照组 |
Lanczos 这一行是对照组。没有对照组的超分评测不成立,下面第四个问题正是对照组设置不当造成的。
遇到的问题
1. 预乘 alpha 不能直接送进网络
预乘图的半透明边缘像素,RGB 已经被 alpha 压暗。送进网络等于让模型去锐化一批并不存在的边。 正确做法是使用直通 alpha 的母版,RGB 与 alpha 分别过网络(alpha 复制成三通道当灰度图处理), 推理完成后再按运行时约定重新预乘。
2. ESRGAN 会把细弱的 alpha 当噪点抹掉
代价最大的一个问题。第一次跑完之后,最终画面少了四个元素,不是变糊,而是整体变成全透明。
逐块测量 alpha 之后定位到原因:一个 14×3 的小块,原始 alpha 峰值 33/255, 超分后峰值为 0,质量比 0.024。模型把这条接近不可见的线判成了压缩噪点并清除。
处理方式是加一道闸门:每个小块同时计算 SR alpha 与 Lanczos alpha, 只有 SR 的 alpha 质量比落在 [0.95, 1.05] 区间内才采用,否则该块的 alpha 退回 Lanczos, RGB 仍然走网络。180 个小块中有 27 个触发退回。
闸门的第一版是失效的。写回顺序按面积从大到小,那 27 个小块没有机会写入自己的像素。 改成从小到大写入、已写像素不再覆盖之后才真正生效。
3. 先归一化 alpha 再超分是死路
思路是既然模型嫌这一块太淡,就先把它的 alpha 归一化到满量程,超分后再反变换回去。
第一次实现时,量程取在了包含相邻内容的上下文块上。上下文里几乎总有 alpha=255 的像素, 归一化因此退化成恒等变换,最大偏差 3e-5,该轮实验没有产生任何信息。
改成取小块自身的量程重跑:对被抹掉的那条线没有任何改善(0.024 到 0.024), HAT-L 反而明显变差,闸门失败数从 4 涨到 13。
结论是模型删除它的原因不是量程低,而是它的形态接近噪声。这个方向不需要再尝试。
4. 对照组必须与候选走完全相同的边界处理
最初的参照系是把小块紧裁出来后 Lanczos 放大,而候选走的是带 12px 真实上下文进网络、 推理后裁回。仅这一处边界差异,就足以把 180 个小块中的 38 个判成回归, 即使候选本身就是 Lanczos。
改成参照系与候选共用同一个上下文块之后,Lanczos 对照组的锐度、颜色、alpha 三项比值 精确等于 1.000,180 个小块全部判为中性。此后每一处偏离才可以归因到网络。
5. 评分里缺少噪点指标
最初的评分包含三类:收益看锐度(laplacian 方差比 ≥ 2.0),代价看 alpha 覆盖量、明暗和色阶。
问题在于,一个只是把源图已有高频残留放大的模型,这三项都能拿高分。 DAT-2 与 HAT-L 属于这种情况,放大到 9:1 观察,边缘有明显的颗粒和阶梯。
补测 resid = luma − median3x3(luma) 之后,差异才显现:
| 模型 | 平均 |resid| | 高幅噪点占画稿像素 |
|---|---|---|
| Lanczos 对照 | 0.131 | 0.036% |
| ESRGAN anime6B | 0.289 | 0.542% |
| DAT-2 x2 | 0.363 | 0.695% |
成因也已确认,不是分块推理造成的:整块一次性送进网络,结果与分块一致。 DAT-2 和 HAT-L 是在 bicubic 退化下训练的经典 SR 模型,而源图并非 bicubic 降采样得到, 它们不做去退化,只做锐化,因此把源图自带的编码残留一并放大了。
6. 裁切级的锐度数字不可靠
第一版报告里,脸部裁切的 laplacian 方差从 31 涨到 291,被记为"眼睛收益最大,+845%"。
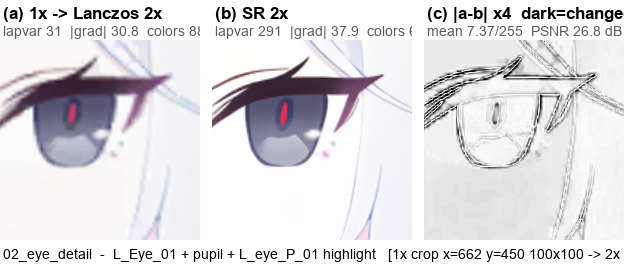
把统计拆到每个元素单独进行之后,结论变了:这部分收益几乎全部来自睫毛线和眉毛这类黑线 (×9.9 至 ×11.5),虹膜本身只有 ×2.5,其中一侧的瞳孔只有 ×1.67。
裁切区域里混有线条,线条一锐化,整块的方差就被拉高。锐度指标需要拆到最小单位再读。
7. 实际被改变的是中间调
按亮度分箱统计整幅画面:
| 亮度带 | Lanczos 放大 | 超分 | 变化 |
|---|---|---|---|
| 250–255(近白) | 6,510,930 | 6,798,478 | +4.42% |
| 240–249 | 373,524 | 205,438 | −45.00% |
| 200–239 | 518,338 | 418,949 | −19.17% |
| 100–199 | 120,744 | 89,583 | −25.81% |
| 0–99(暗部) | 2,951,125 | 2,962,213 | +0.38% |
两端几乎不动,中间三段下降 19% 至 45%。这是对比度提升的典型特征,像素被从过渡带推向两极。
线条方面,"线变细了"这个判断不成立:亮度 <128 的覆盖面积只差 0.18%。
变化发生在最深的部分,<32 的像素减少 8.9%,被抬进 32 至 64 区间。
直接比较超分前后的原图也得到同样结果:浅色被抬高 3.4 至 4.3,深色基本不变 (浅色的脸 +3.63、眼白 +3.43,深色的大衣 +0.25、深色的武器 −0.32)。 因此脸、眼白、高光这些最浅的区域,损失了原本就很微弱的明暗分离。
8. 羽化带宽度不随图像放大
统计 8 < alpha < 247 的像素占有覆盖像素的比例:原图 8.114%,2x 超分后 4.410%,
相对柔度比 0.543。比值 1.00 表示羽化带随图像一同放大(Lanczos 的行为),
0.50 表示羽化带保持原有的像素宽度。
实测值说明超分把软边固定在了约 1px。同一个机制在不同素材上后果相反: 硬轮廓(武器、手指、发丝)因此受益,而本应保持柔和的元素 (加色光晕、腮红、柔光阴影)失去了过渡。
9. x4 后降采样与 native x2 的差别不是主因
| 模型 | 路线 | 240–249 亮度带 |
|---|---|---|
| ESRGAN anime6B | x4 → Lanczos 缩半 | −54.2% |
| DAT-2 | x4 → Lanczos 缩半 | −11.4% |
| DAT-2 | native x2 | −10.7% |
| APISR RRDB | native x2 | −39.8% |
| Real-CUGAN conservative | native x2 | −6.8% |
同一路线下跨模型可以差 5 倍,同一模型跨路线只差 0.7 个百分点。决定结果的是模型,不是路线。
10. RGB 与 alpha 可以完全解耦
素材存的是直通 alpha,两条通路互不影响,任何模型的 alpha 都可以配任何模型的 RGB。
这一点后来改变了整个方案。把 DAT-2 的 alpha 接到 ESRGAN 的 RGB 上, 闸门失败数从 27 降到 3,细弱小块的保留数从 7/26 升到 23/26,RGB 侧不受任何影响。
排名
修正对照组、补上噪点指标之后重跑,按回归数升序、纯改善数降序排列(节选):
| 候选 | 架构 | 倍率 | 回归 | 纯改善 | 闸门失败 | 240s 带 | 噪点 |
|---|---|---|---|---|---|---|---|
| Lanczos(对照) | — | x2 | 0 | 0 | 13 | +0.0 | 1.00 |
| IllustJaNai_DAT2_x4 | DAT | x4→L | 1 | 4 | 17 | −13.6 | 3.06 |
| DAT2_x4 | DAT | x4→L | 2 | 43 | 4 | −11.4 | 4.24 |
| HAT_L_x4 | HAT | x4→L | 2 | 36 | 4 | −9.7 | 4.80 |
| DAT2_x2 | DAT | x2 | 3 | 41 | 3 | −10.7 | 4.36 |
| APISR2x_RRDB | ESRGAN | x2 | 4 | 37 | 47 | −39.8 | 2.65 |
| cugan4x_conservative | RealCUGAN | x4→L | 4 | 29 | 15 | −7.8 | 2.31 |
| AnimeSharp_x4 | ESRGAN | x4→L | 4 | 18 | 6 | −28.0 | 2.74 |
| ESRGAN_anime6B_x4 | ESRGAN | x4→L | 4 | 1 | 25 | −54.2 | 2.98 |
| cugan2x_conservative | RealCUGAN | x2 | 5 | 15 | 26 | −6.8 | 1.97 |
| RealHAT_GAN_sharper_x4 | HAT | x4→L | 12 | 7 | 41 | −31.1 | 2.68 |
各候选的具体问题:
- APISR(四个变体):锐度最高,但它在重画线条。虹膜暗环被压到 22/255,墨量翻倍; 平坦区局部对比度达到 Lanczos 的 11.8 倍,出现明显振铃;alpha 是全场最差的一档。 它声称针对手绘线条的退化建模,实测行为是强化重绘而非保真。
- HAT-L:保真类指标表现好,噪点是全场最高。
- Real-CUGAN conservative:噪点最低,中间调保持最好,但放大幅度很小, 眼部锐度只有 ×1.61。它的保真来自于几乎没有改动图像。开启去噪后行为与 ESRGAN 一致,同样推白。
- RealHAT_GAN_sharper:12 个回归,眼部锐度比 0.33,眼睛被模糊掉。
- AnimeSharp / Remacri:干净但收益有限,中间调下降 24% 至 28%,没有选择理由。
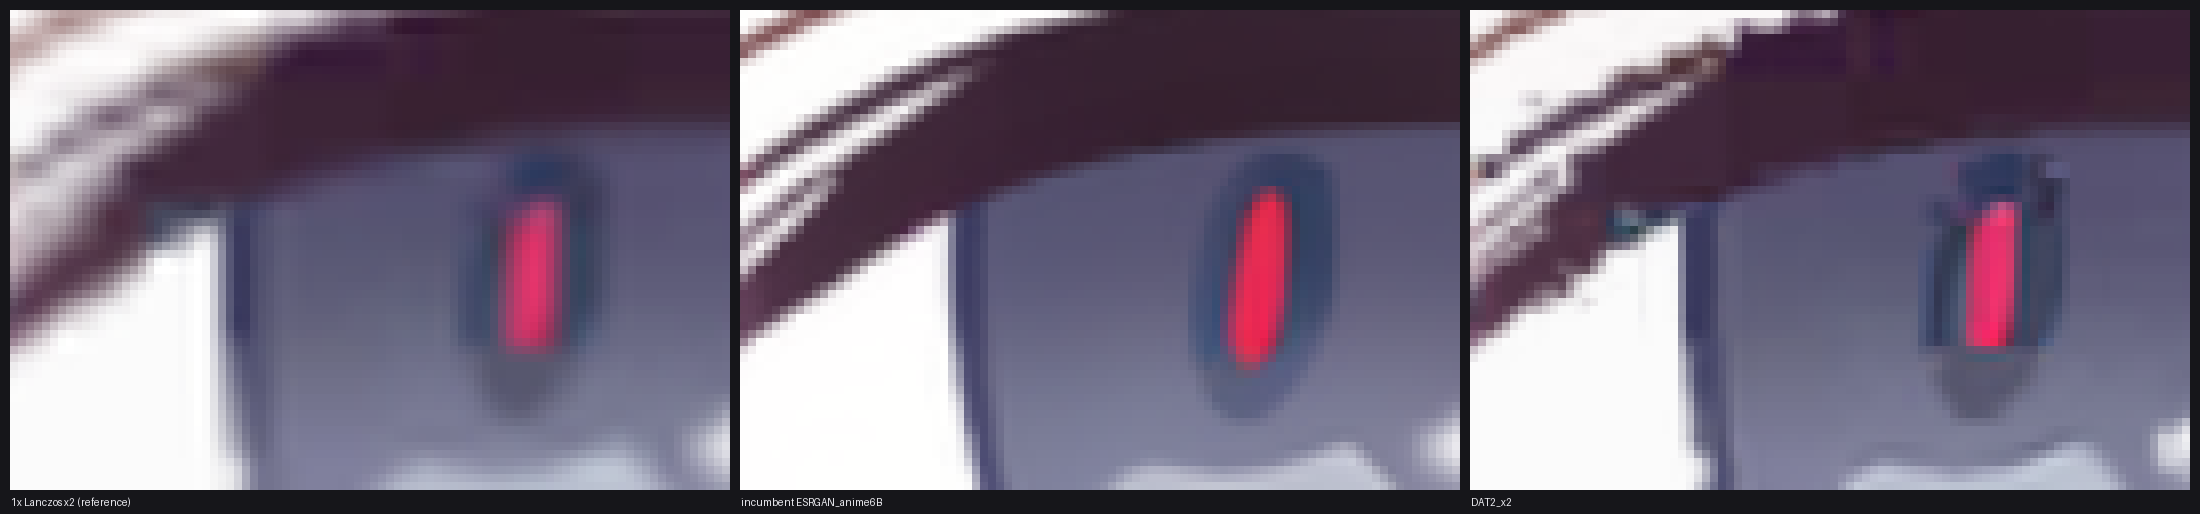
按这套指标,DAT-2 native x2 排第一:89 个元素中有 78 个属于纯改善(ESRGAN 为 11 个), 掉色阶的元素从 65 个降到 3 个,颜色比几何均值 1.095,高于 Lanczos, 说明它在放大过程中解析出了更多层次,而不是生成色块。
结论的修正
目视对比中我始终认为 ESRGAN 的线条重建质量明显更好,与上述排名不符。 换一批素材、改变测量层级后重新测量,结果是在最终合成画面上, ESRGAN 的锐度高出 13% 至 36%,同时噪点更低,三组素材、两项指标全部占优,与前面的排名相反。
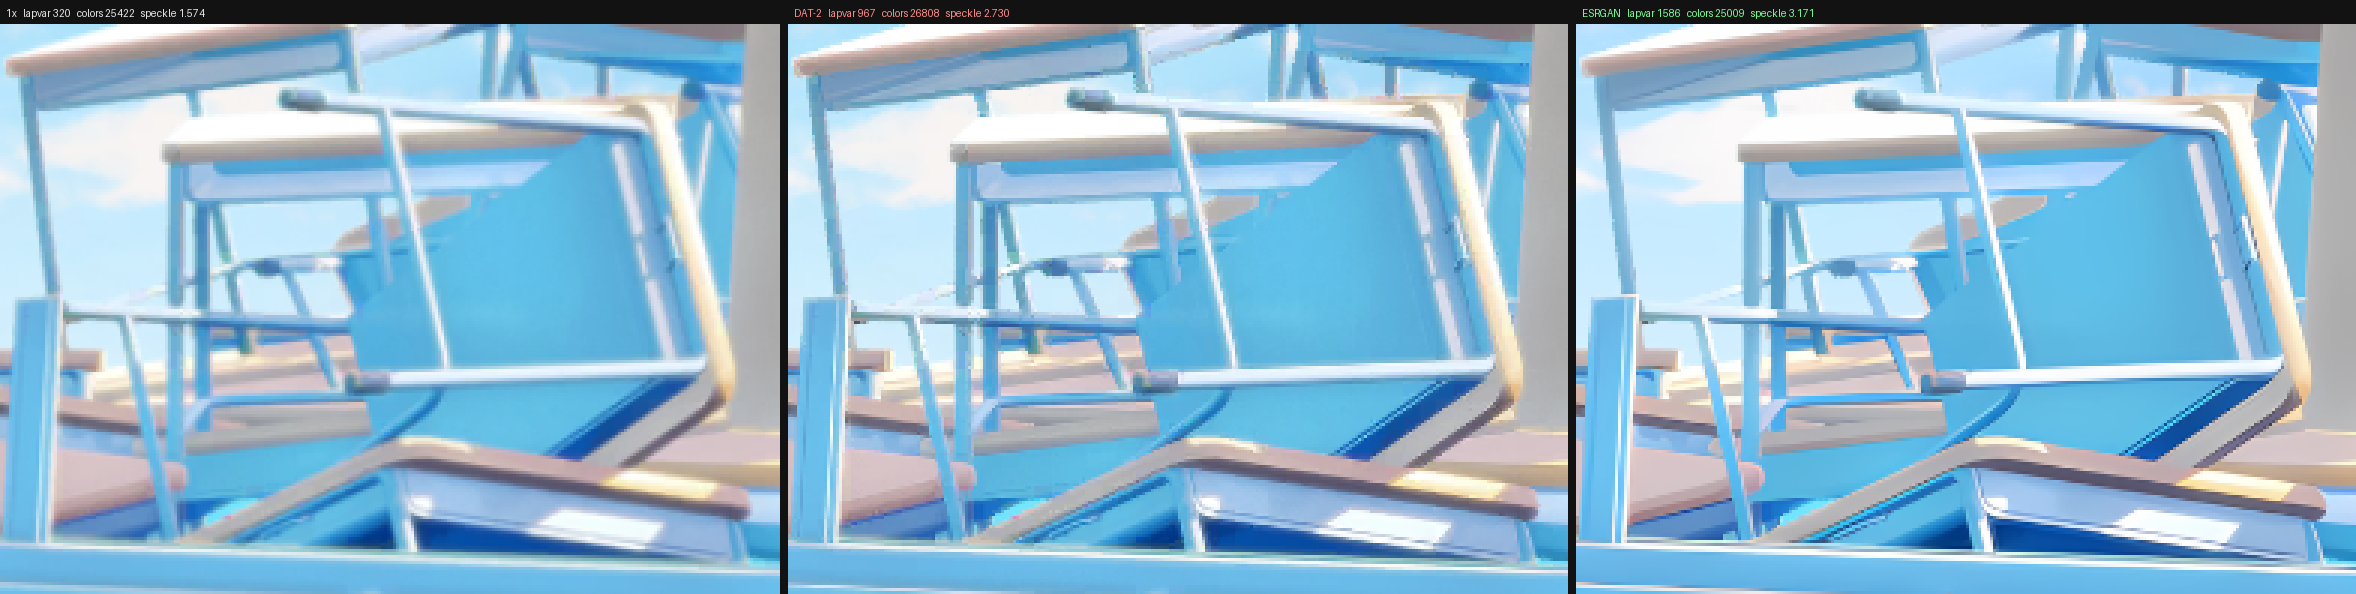
两次测量都没有出错,差异来自三处:
- 测量层级不同。 前一套排名测的是每个元素单独裁切、透明底的结果, 这次测的是最终合成画面。两者的判定一致率只有 75%。
- 素材类型不同。 前者是角色线稿,后者接近照片的场景图。 ESRGAN 的 anime 权重在这两类内容上的行为差别很大。
- ESRGAN 的主要缺陷被绕开了。 这一轮 alpha 走 DAT-2 供体(见第 10 条), 闸门在 646 个小块中只触发 3 次。它在第一次评测里失分最多的那一项已经不在链路中。
这里的结论不是目视判断优于量化指标,而是第一次测量的对象与实际用途不匹配。 那套优先级排序服务于"作为后续加工的源素材",而不是"直接渲染的成品", 用途改变之后,排序随之改变。
GAN 的行为是重建而非保真
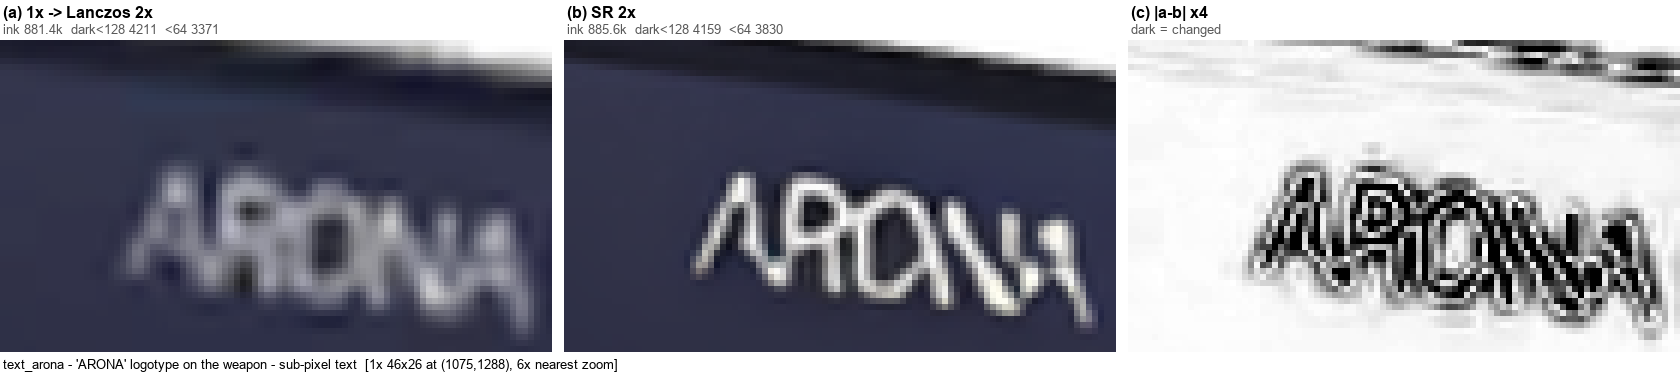
上图是一处亚像素文字。左侧是可辨认的模糊字形,中间笔画变干净,但字形被改写: 末尾的 A 变成一个实心楔形,R 的腿也被重新绘制。深色像素数增加 13.6%, 即笔画被加粗并重新造型。这是 GAN 在亚像素文字上的典型行为, 且分辨率提高之后更容易被识别为伪造。
量化结果一致:将 2x 结果缩回原尺寸后与真实原图比较,PSNR 只有 27 至 35 dB, DAT-2 为 40 至 50 dB。模型确实改写了原图。
结论
不存在通用意义上最好的超分模型,只有对特定测量层级、特定素材类型和特定用途最合适的模型。
四个候选的定位:
- RealESRGAN anime6B:线条重建能力最强,噪点低。代价是中间调损失明显 (240–249 亮度带 −45%)、会把细弱 alpha 当噪点清除、对亚像素文字产生幻觉。 适合直接呈现给人看的成品。
- DAT-2 x2:色阶保持最好(掉色阶从 65 降到 3),alpha 全程稳定,没有元素被清除。 代价是边缘噪点比 ESRGAN 高 28%。适合作为后续加工的源素材。
- Real-CUGAN conservative:最保守,收益也最小。需要确保不出问题时可以选择。
- APISR:锐度最高,但行为是重绘而非保真。用于成品放大可行,用作源素材不可行。
最终采用的是混合方案,RGB 走 ESRGAN,alpha 走 DAT-2 供体。 这不是折中的结果,而是两条通路本来就互不影响,两个模型各自的优势恰好落在不同通路上。
方法上有几点适用于其他类似的评测:
- 设置 Lanczos 对照组,并保证它与候选走完全相同的预处理。
- 先确定测量层级,是单个元素还是最终画面。这一步选错会导致后续全部结论失效。
- 锐度指标拆到最小单位再读,裁切级的数字会被其中的线条带偏。
- 评分中加入噪点指标。只奖励锐度的评分会把放大源图噪声的模型排到前面。
- 带 alpha 的素材,RGB 与 alpha 分开处理、分别选型。